gputaskman, el monitor de GPU de código abierto que desglosa la VRAM de cada proceso y de cada modelo de IA
Scott Hanselman, vicepresidente de Microsoft, ha publicado gputaskman, una herramienta experimental y MIT que muestra qué proceso consume cada bloque de VRAM, la actividad del runtime y, en el caso de modelos locales, el peso, la caché KV y el número de parámetros.
Publicidad
Cuando un modelo de lenguaje local se queda sin memoria, el administrador de tareas de Windows no siempre ayuda: muestra el uso agregado de la GPU, pero no qué proceso o qué parte del modelo ocupa cada bloque de VRAM. Scott Hanselman, vicepresidente de Microsoft y una de las caras más visibles de su ecosistema para desarrolladores, ha publicado gputaskman, una herramienta de código abierto que intenta responder a esa pregunta.
El proyecto es experimental, se distribuye con licencia MIT y no es un producto oficial de Microsoft. Funciona en Windows, Linux —incluido WSL— y macOS con Apple Silicon, y combina una interfaz de terminal con gráficas en vivo. La versión actual, la 0.3.4, también está publicada en PyPI como paquete de Python.
Qué muestra en pantalla
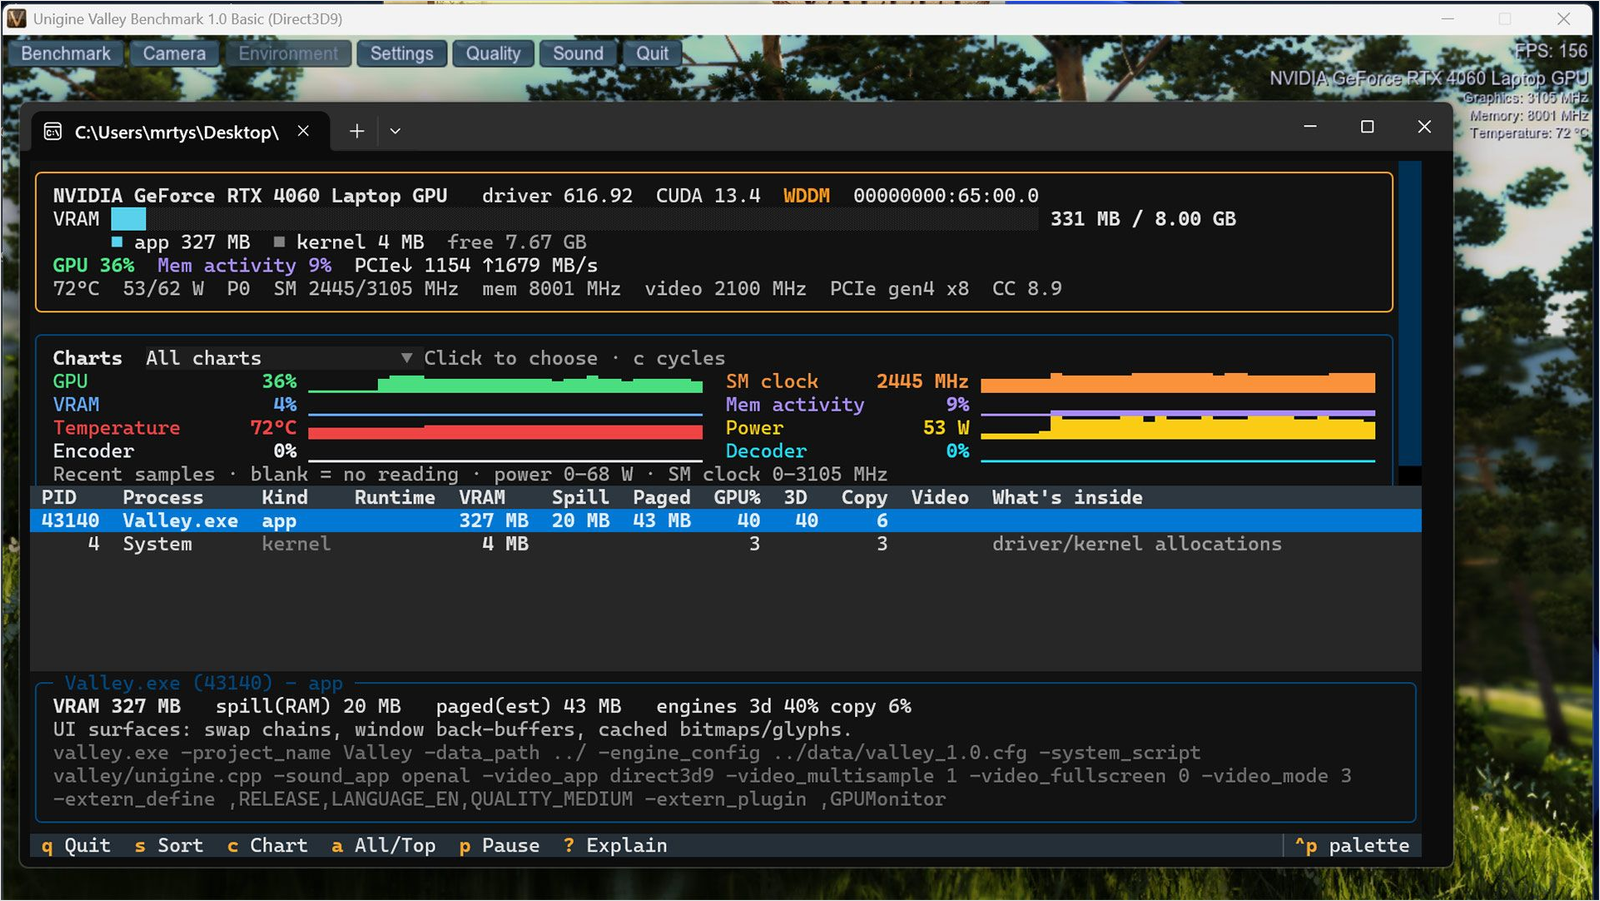
La vista principal resume el estado de la GPU: modelo, driver, versión de CUDA, memoria total y libre, utilización, temperatura, potencia, relojes y ancho de banda del bus. Debajo aparecen gráficas de evolución y una tabla de procesos ordenada por consumo. Cada fila indica el PID, el nombre del proceso, el tipo de carga, la VRAM asignada, la memoria paginada y la actividad de los motores de cómputo, copia y vídeo.
La diferencia frente a un monitor genérico está en el desglose. Al seleccionar un proceso, gputaskman muestra qué parte de la memoria corresponde a la aplicación, al kernel o a la caché, y qué runtime está utilizando. En el caso de servidores de inferencia como llama-server, añade una ficha del modelo: nombre, número de parámetros, tamaño de los pesos, tamaño de la caché KV y otros datos útiles para saber si el modelo cabe o no en la GPU.
Las capturas publicadas por Hanselman muestran un equipo con una RTX 4080 Super en el que el gestor de ventanas de Windows es el proceso que más VRAM consume, por delante de las aplicaciones de IA. En la prueba de Tom’s Hardware, el autor tuvo que lanzar el benchmark Unigine Valley para que la GPU discreta de su portátil con RTX 4060 apareciera activa. Son ejemplos, no una garantía de que la herramienta detecte todas las cargas en todos los sistemas.
Cómo obtiene los datos y qué límites tiene
gputaskman no es un controlador ni un monitor a nivel de hardware: se apoya en las interfaces que exponen los drivers y el sistema operativo. Eso explica su portabilidad, pero también sus límites. Parte de las cifras de memoria son estimaciones, especialmente cuando el driver no separa la memoria compartida de la dedicada o cuando la aplicación usa asignaciones que el sistema contabiliza de forma agregada.
La herramienta tampoco sustituye a los monitores de los fabricantes. No permite overclocking, no controla ventiladores y no hace capturas de depuración. Su valor es la visibilidad por proceso y la capacidad de relacionar un modelo de IA con el consumo real de memoria. Para diagnosticar un out of memory en una inferencia local, esa asociación es más útil que un porcentaje global.
Publicidad
Hay otro detalle práctico: al ser una aplicación de Python que consulta el estado del sistema con frecuencia, puede añadir cierta carga de CPU. En los comentarios de la cobertura de Tom’s Hardware, un usuario describió un aumento del proceso System de Windows mientras la herramienta estaba abierta. No es una medición controlada ni afecta a todos los equipos, pero conviene tenerlo en cuenta si se deja ejecutando en segundo plano.
Para qué sirve si ejecutas modelos de IA en local
La utilidad más clara es previa a la ejecución. Antes de cargar un modelo, gputaskman permite ver cuánta VRAM está realmente libre y qué procesos la ocupan. En un equipo con escritorio, navegador, reproductor de vídeo y varias aplicaciones abiertas, la diferencia entre la memoria nominal y la disponible puede ser de varios gigabytes.
Durante la ejecución, el desglose de pesos y caché KV ayuda a entender por qué un modelo entra con una ventana de contexto corta y falla al ampliarla. La caché KV crece con el contexto y con el número de capas y cabezas de atención; verla separada de los pesos permite dimensionar mejor el modelo, el contexto y el lote. También ayuda a comparar cuantizaciones: dos archivos del mismo modelo pueden ocupar distinto y comportarse de forma diferente.
En servidores con varias GPU, la vista por proceso permite detectar si una carga se está repartiendo mal o si un proceso huérfano retiene memoria. En estaciones de trabajo compartidas, ayuda a identificar al usuario o servicio responsable sin reiniciar la máquina. Son tareas de administración básicas, pero hasta ahora requerían combinar varias herramientas.
Cómo probarlo sin convertirlo en dependencia
El código y las instrucciones están en GitHub. Al tratarse de software experimental, lo razonable es instalarlo en un entorno virtual de Python, revisar los requisitos de los drivers y no desplegarlo en producción sin comprobar antes su comportamiento. En Windows hay además ejecutables portables para quien prefiera no instalar Python.
No es un producto de Microsoft ni cuenta con soporte oficial. Hanselman lo describe como una herramienta para resolver una necesidad propia, y la licencia MIT permite usarlo, modificarlo y redistribuirlo con atribución. Esa libertad también significa que la calidad y la continuidad dependen del proyecto, no de un contrato de soporte.
Su mayor aportación es hacer visible una capa que suele quedar oculta: la memoria de la GPU es un recurso escaso y caro, y saber quién la usa es el primer paso para gestionarla. Quien ejecute modelos locales, juegue y trabaje en el mismo equipo lo notará rápido.
Fuentes
Publicidad